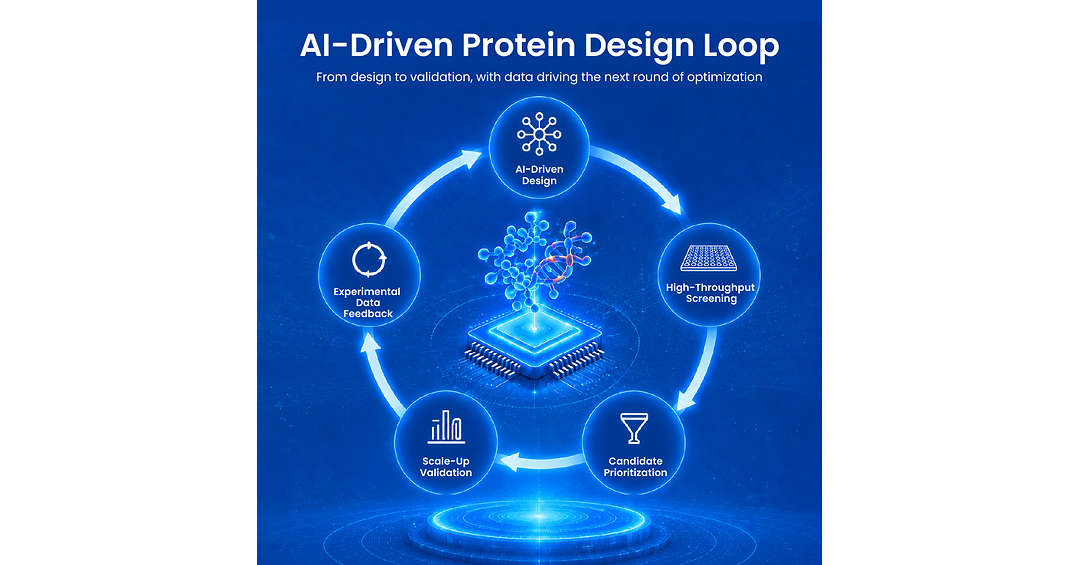
北京擎科生物(Tsingke Biotech)於2026年9月22日正式發表一套整合型高通量驗證工作流程,專門用於將人工智慧設計的大量蛋白質與抗體候選序列,快速推進至實驗驗證階段。該平台整合了基因合成、平行表現、高通量篩選、規模化生產、純化以及定量結合分析等六大核心環節,直指當前AI蛋白質設計領域「算得快、做不動」的關鍵瓶頸。
擎科將驗證流程劃分為兩階段:第一階段聚焦高通量候選生成與初步篩選,透過批次基因合成與平行蛋白/抗體表現,可在短時間內完成ELISA結合分析;第二階段則針對表現優異的候選分子進行擴增表現、純化與克級量產,並利用生物層干涉技術(BLI)或表面電漿共振(SPR)測定親和力動力學參數(KD、kon、koff)。
在技術規格上,擎科宣稱其基因合成涵蓋長達200 kb的DNA片段及高GC含量、串聯重複、回文序列等高難度構築,並透過自研GeneOptimizer演算法進行密碼子優化。抗體表現方面,單日可處理多達1,500個候選樣本,基因到抗體交付最快僅需7個日曆天(含5天物流),支援scFv、VHH、Fab、全長IgG等多種抗體格式。
此事件本質屬於生技服務產業的技術演進與服務模式創新,並非傳統意義上的地緣政治衝突或法規監管角力,因此不宜強加政治陰謀論框架。真正的結構性張力來自於「AI運算爆量」與「濕實驗產能瓶頸」之間的嚴重供需失衡,這是一場橫跨學術界、製藥界與服務供應商的典範轉移。
回顧產業演進,自DeepMind推出AlphaFold、David Baker團隊發表RFdiffusion與ProteinMPNN等開源工具以來,蛋白質結構預測與序列設計的「入口端」已被徹底民主化。研究人員可在數小時內產生成千上萬條候選序列,但傳統「一對一」濕實驗驗證流程卻仍以線性速度運作,形成所謂的「實驗室產能塌陷」(lab capacity bottleneck)。擎科正是精準切入此痛點。
值得關注的產業結構性因素有三:
回顧歷史,製藥產業經歷過幾次類似的「乾濕整合」典範轉移:1990年代基因合成商業化讓研究人員擺脫手工定序;2010年代次世代定序(NGS)將基因體資料產出成本降低萬倍。每一次「上游工具民主化」都必然催生「下游服務工業化」的商機,AI蛋白質設計正複製同一劇本。
基於此歷史脈絡與當前產業動能,可預測三種未來情境:
面對AI製藥「算力過剩、實驗產能稀缺」的新常態,各利害關係人應採差異化行動:
01 起因觸發:AlphaFold、RFdiffusion等AI設計工具民主化,候選序列從數十暴增至數千條,傳統線性實驗流程不堪負荷
02 一階傳傳導:生技CDMO/CRO產業迎來「高通量濕實驗」軍備競賽,擎科、藥明生物、GenScript等中港廠商加速整合型平台佈局
03 二階擴散:AI製藥新創公司商業模式從「全自研」轉向「輕資產+重服務夥伴」,跨國藥廠研發外包預算結構性提升
04 宏觀終局:全球製藥研發週期有望從5年壓縮至2年,但地緣供應鏈將呈現「中港濕實驗+歐美臨床/監管」的分工新秩序
因果網路圖譜 3 節點
可拖曳節點 · 點兩下開啟文章