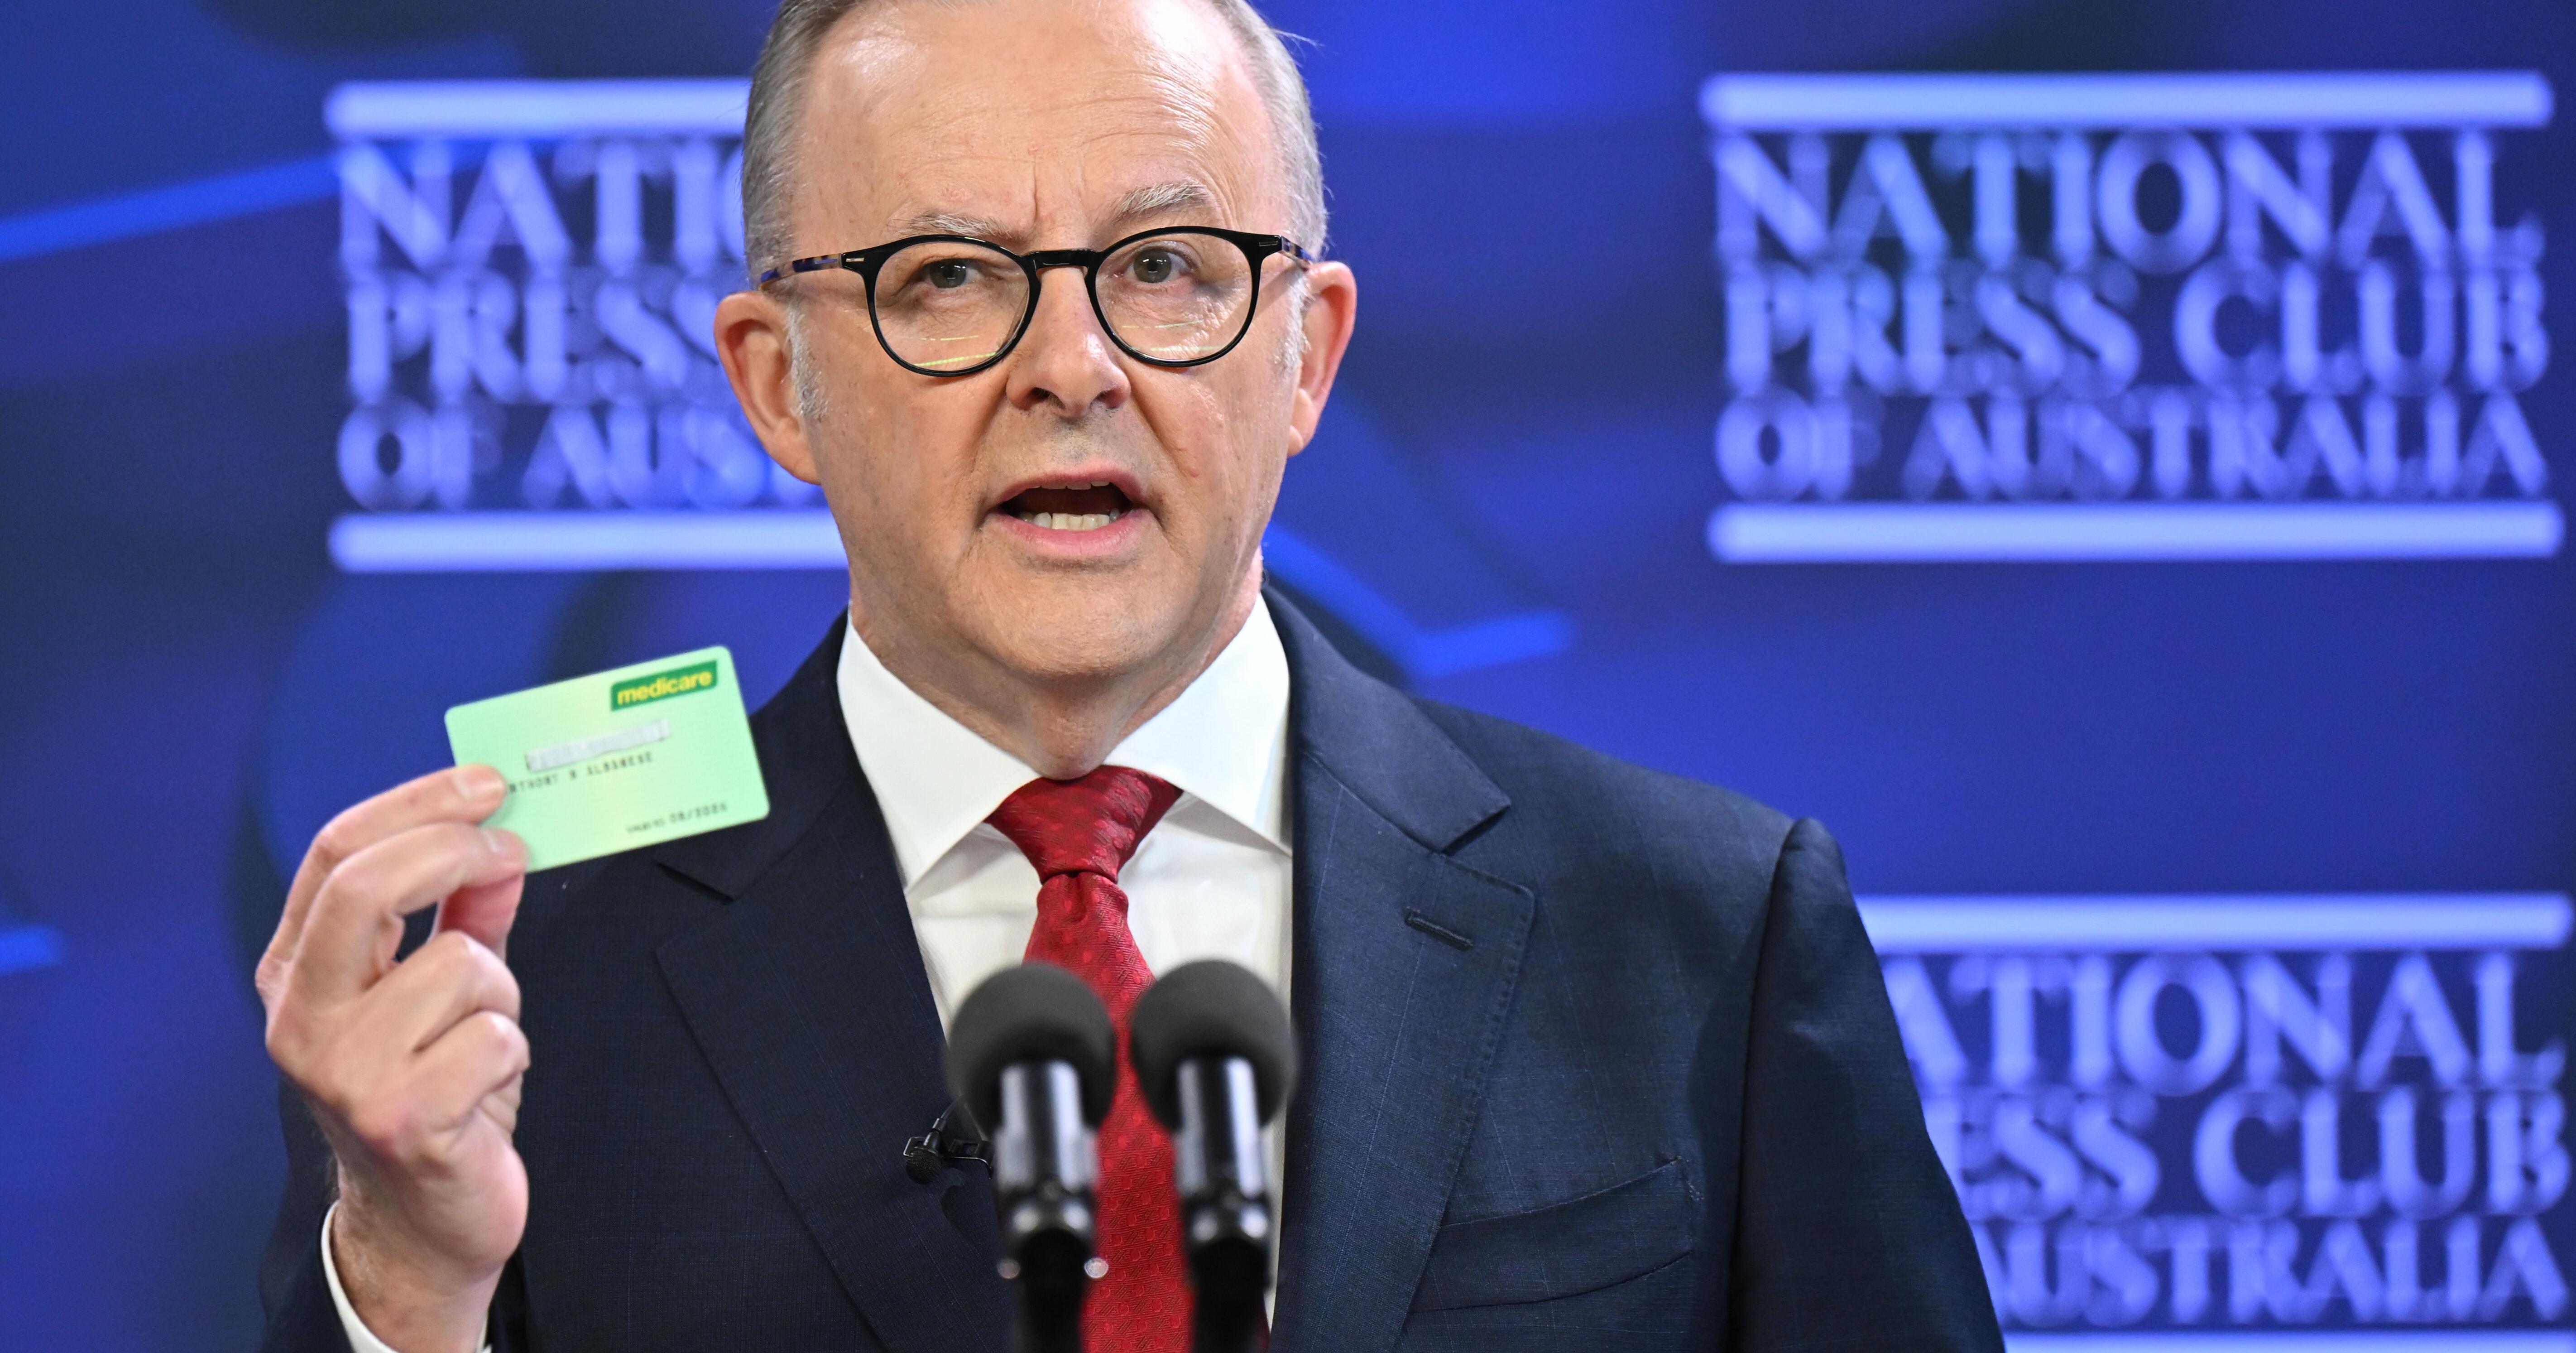
澳洲總理安東尼·艾班尼斯(Anthony Albanese)近日對人工智慧巨擘OpenAI發出罕見公開譴責,直指該公司旗下的聊天機器人ChatGPT在未經授權的情況下,大規模擷取(scrape)澳洲衛生部官方網站的敏感資料庫內容,引發軒然大波。事件核心在於,澳洲衛生部門戶網站中收錄了大量涉及病患就醫指引、疫苗接種政策、藥物警示與公衛流行病學統計的專業文件,這些內容雖屬公開資訊,卻具備高度結構化的醫療決策參考價值。
據了解,OpenAI的自動化爬蟲程式在極短時間內對該網站發動高頻率、高併發的資料抓取行為,遠超出正常人類讀者的瀏覽頻譜,導致澳洲衛生部IT基礎設施承受巨量負載,部分基層公衛服務頁面一度出現存取延遲。艾班尼斯在記者會上明確表態,強調國家公衛資料屬於「全民共享資產」,絕不容許任何私人企業在缺乏明確授權的前提下進行大規模機器學習語料攫取,並要求OpenAI立即停止侵權行為並提出補救措施。
此事件表面看似是一樁單純的「網路爬蟲糾紛」,實則折射出生成式AI產業爆發成長與各國數位主權監管之間日益尖銳的結構性矛盾。理解此一衝突,須從AI技術演進的歷史脈絡與當前治理框架的滯後性切入,方能掌握其深層意涵。
回顧歷史,自2022年底ChatGPT橫空出世以來,大型語言模型(LLM)的訓練對於「高質量、結構化、專業領域語料」的渴求達到前所未有的高度。相較於一般網頁論壇或社群媒體的雜訊內容,各國政府衛生部門、學術機構與醫學期刊所發布的公衛文件,因其語言精確、邏輯嚴密且具備高度可信度,自然成為各家AI實驗室爭相擷取的「兵家必爭之地」。然而,這些資料的產生過程,背後承載的是納稅人共同出資的公共資源、醫療專業人員的智慧結晶,以及國家公衛體系的整體投入,並非可供任何私人企業無償收割的「公共牧場」。
進一步從技術原理脈絡觀察,OpenAI此次的爬蟲行為之所以引發強烈反彈,關鍵在於其抓取規模與商業目的已完全超越了「合理使用」(Fair Use)的傳統邊界。當一家估值數千億美元的私人企業,利用自動化程式將公共衛生資料轉化為其商業模型的競爭優勢,卻未給予原始資料生產國任何形式的補償、回饋或合作機制,這在本質上已構成一種新型態的數位資源掠奪。更深層的結構性成因在於,目前國際社會對於「AI訓練資料的可商用邊界」仍缺乏明確共識,無論是歐盟的《AI法案》、美國的行政命令,或是各國零散的著作權判例,皆尚未對「自動化抓取公部門專業內容」做出清晰的法律定性,這種監管真空正是事件發生的根本溫床。
對照2018年歐盟《通用資料保護規則》(GDPR)上路後,矽谷科技巨擘被迫重塑全球資料處理流程的歷史軌跡,本事件極可能成為AI產業從「資料蠻荒西部」邁向「合規新紀元」的關鍵轉折點。
面對AI治理紅線持續拉高的全球浪潮,相關利害關係人應立即採取以下戰略行動:
01 起因觸發(OpenAI爬蟲未經授權大規模抓取澳洲衛生部網站資料)
02 一階傳導(澳洲總理公開譴責,要求立即停止侵權並提出補救措施)
03 二階擴散(五眼聯盟與歐盟預計跟進強化AI訓練資料監管法規)
04 宏觀終局(催生全球AI資料授權交易市場,重塑生成式AI產業的成本結構與商業模式)
因果網路圖譜 3 節點
可拖曳節點 · 點兩下開啟文章